事件驱动架构非常强大,非常适合分布式微服务环境。 通过引入代理中介,事件驱动架构提供了更好的解耦架构、更容易的可扩展性和更高程度的弹性。
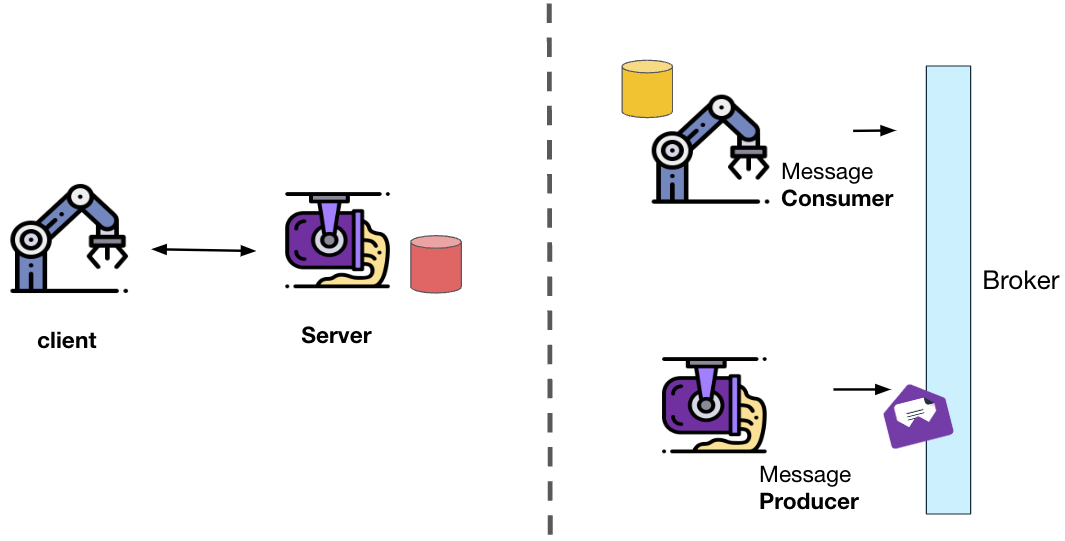 请求应答模式 (client-server) vs. 事件流模式 (pub-sub)
但与请求应答客户端-服务器类型架构相比,事件流模式的搭建更复杂。
在Wix过去的几年里,我们逐渐的将我们不断增长的微服务集(目前为 2300 个)从请求-应答模式迁移到事件驱动架构模式。 下面介绍的就是 Wix 工程师在事件驱动架构的实验过程中遇到的 5 个坑。
这些坑给我们带来了巨大的痛苦,包括生产事件、必要的重写和陡峭的学习曲线。 对于每个坑,我都提供了今天在 Wix 使用的经过实战验证的解决方案。
1. 写入数据库,然后触发没有原子性的事件
例如,考虑一个简单的电子商务购物流程(我们将在本文中都使用这个示例)
付款处理完成后,应更新产品库存以反映该产品是为客户保留的。
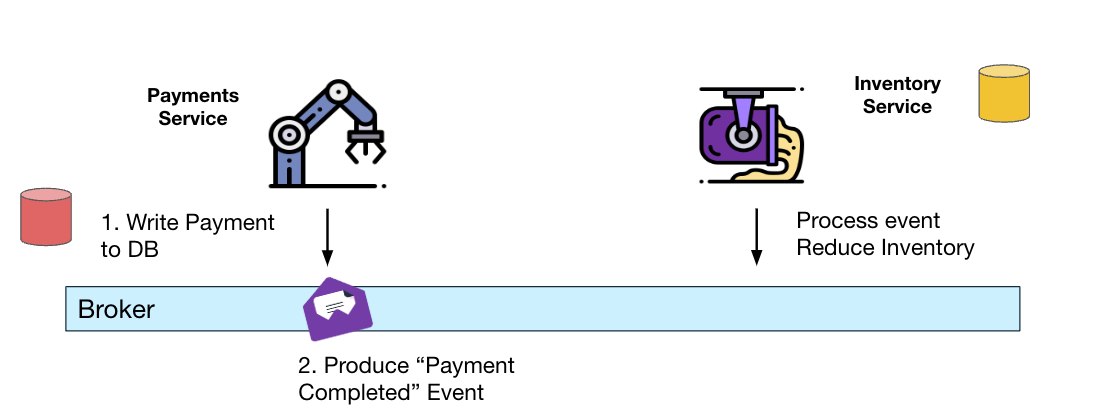 写入数据库并产生一个非原子动作的事件
不幸的是,将支付完成状态写入数据库,然后向 Kafka(或其他消息代理)生成“支付完成”事件并不是原子操作。 实际可能存在仅发生其中一项操作的情况。
例如,数据库不可用或 Kafka 不可用等情况可能会导致分布式系统不同部分之间的数据不一致。 在上述情况下,库存水平可能与实际订单不一致。
原子方案1 - Greyhound 弹性生产者(resilient producer)
有几种方法可以解决这个问题。 在 Wix,我们使用两种方式。 第一个是我们自己的息传递平台,名为
Greyhound,它允许我们确保事件最终通过
弹性生产者写入 Kafka。 这种措施的一个缺点是对下游事件的处理是无序的。
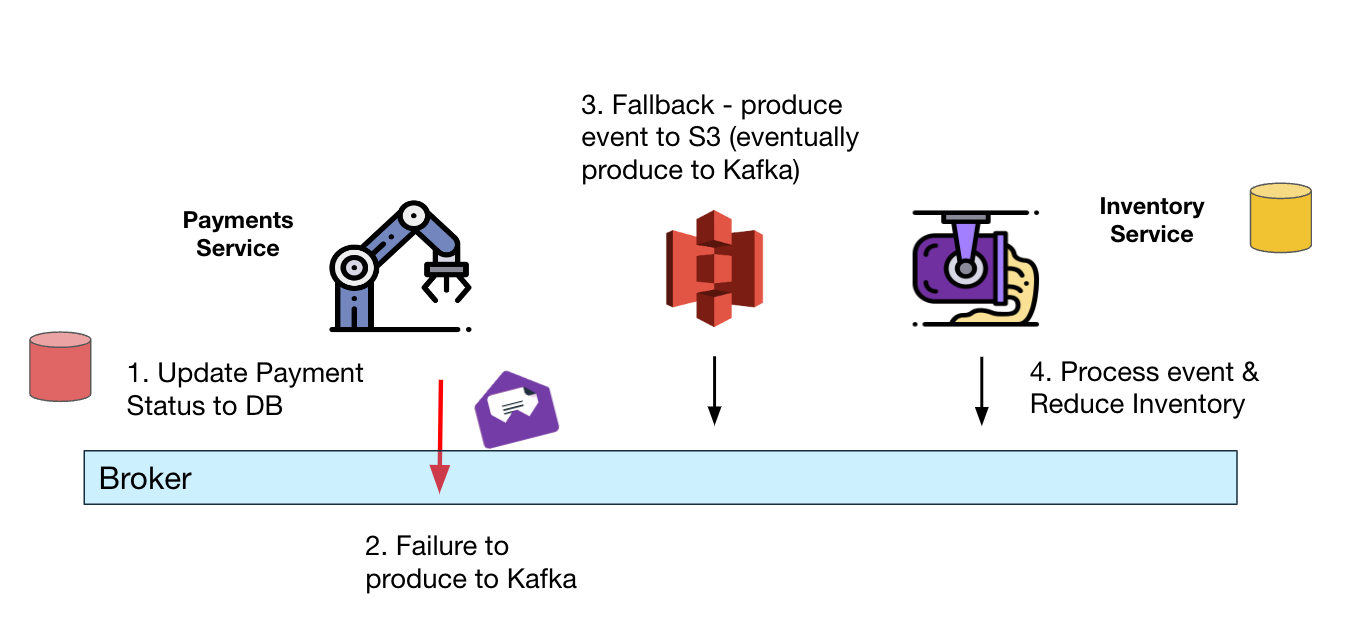 Greyhound生产者回退到 S3。 特定的服务将消息恢复到 Kafka
原子方案2 - Debezium Kafka 源连接器
第二种方法是使用
Debezium Kafka 连接器来确保数据库更新操作和 Kafka 生成操作都发生并且数据保持一致。 Debezium 连接器允许自动捕获数据库中发生的所有更改事件(
CDC)(对于 MySQL,通过
binlog)并将它们生成为 Kafka 事件。
Kafka Connect 与
Debezium DB 连接器一起保证事件最终将生成到 Kafka。 此外,还保证
事件的有序性
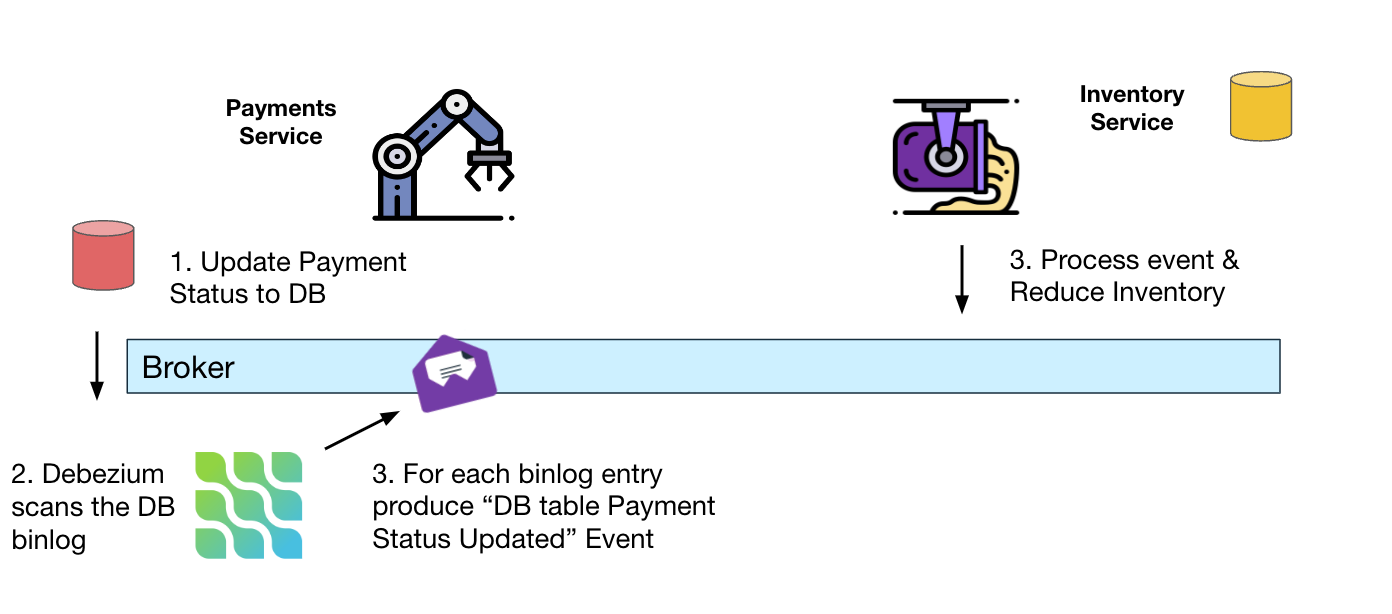 Debezium 连接器确保变动的事件最终与 DB 一致
注意,Debezium 还适用于其他事件流平台,例如
Apache Pulsar。
2. 无处不在的事件溯源
事件溯源是一种特定模式,在这种模式下,服务不会在业务操作时更新实体的状态,而是将事件保存到其数据库中。 该服务通过重放事件来重建实体的当前状态。
这些事件也发布在事件总线上,这样其他服务也可以在其他数据库上创建物化视图(materialized views),这些视图通过重放事件来优化查询。
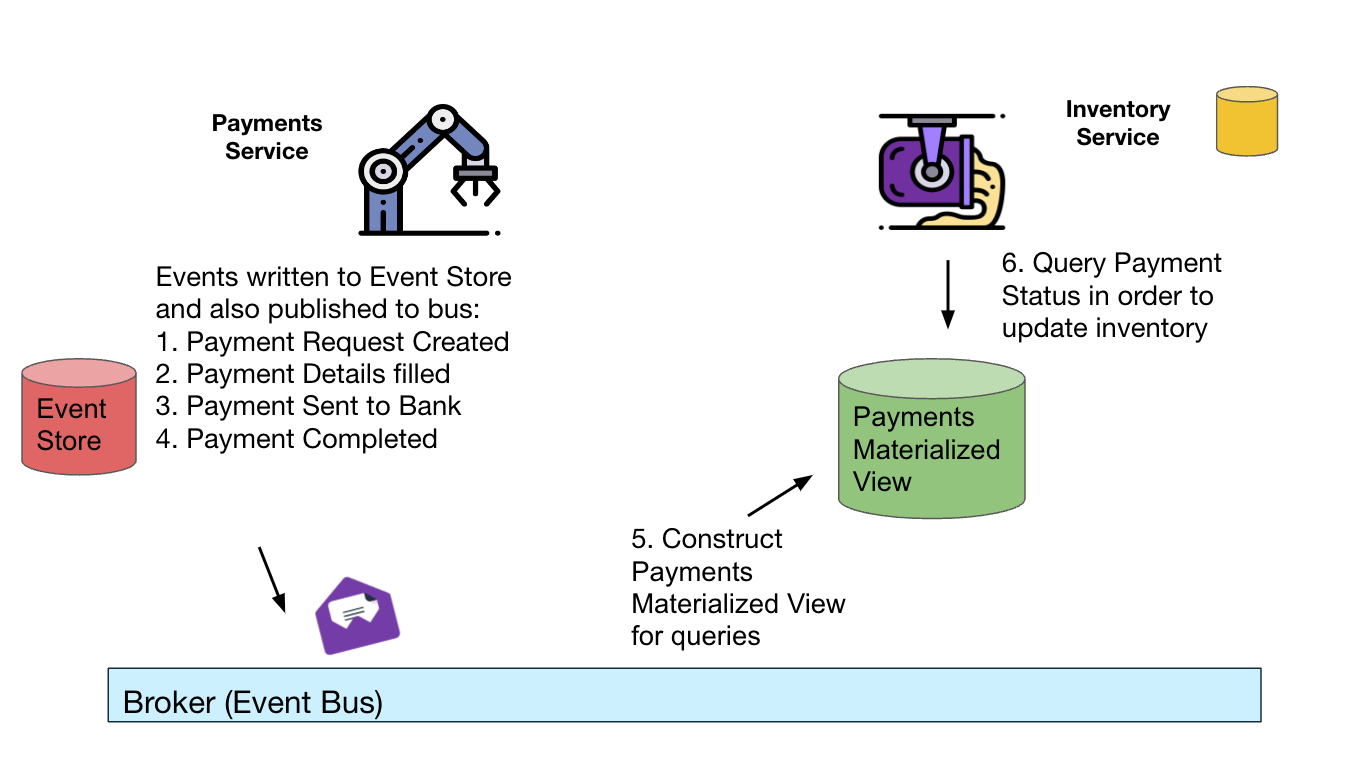 事件溯源——将更改事件持久化到事件存储。 重放事件以达到当前状态
虽然这种模式有一定的优势(可靠的审计日志,执行“时间旅行”——在任何时间点获取实体状态的能力,并对同一数据构建多个视图),但它比更新存储在数据库中的实体状态的
CRUD 服务更复杂。
事件溯源的缺点包括以下几点:
- 复杂性—在重放不断增长的事件同时,为了确保读取性能不受影响, 实体状态快照需要不断的产生以此来减少性能损失。
这增加了系统的复杂性,后台进程可能有自己的问题,这个时候数据可能是陈旧的。 最重要的是,拥有 2 个数据副本意味着它们可能会不同步。 - 雪花性质—与 CRUD ORM 解决方案不同,很难创建通用库和框架来简化开发,从而可以全局解决适合每个用例的快照和读取优化。
- 仅支持最终一致性(对于写后读用例有问题)
事件溯源替代方案—CRUD CDC
利用简单的 CRUD 功能和发布数据库更改事件 (
CDC) 供下游使用(例如,创建查询优化的物化视图)可以降低复杂性、提高灵活性,并且仍然允许针对特定用例的命令查询责任分离 (
CQRS)。
对于大多数用例,该服务可以公开(expose)一个简单的读取端点(endpoint),该端点将从数据库中获取实体的当前状态。 随着规模的增加和需要更复杂的查询,额外发布的更改事件可用于创建专门为复杂查询量身定制的自定义物化视图。
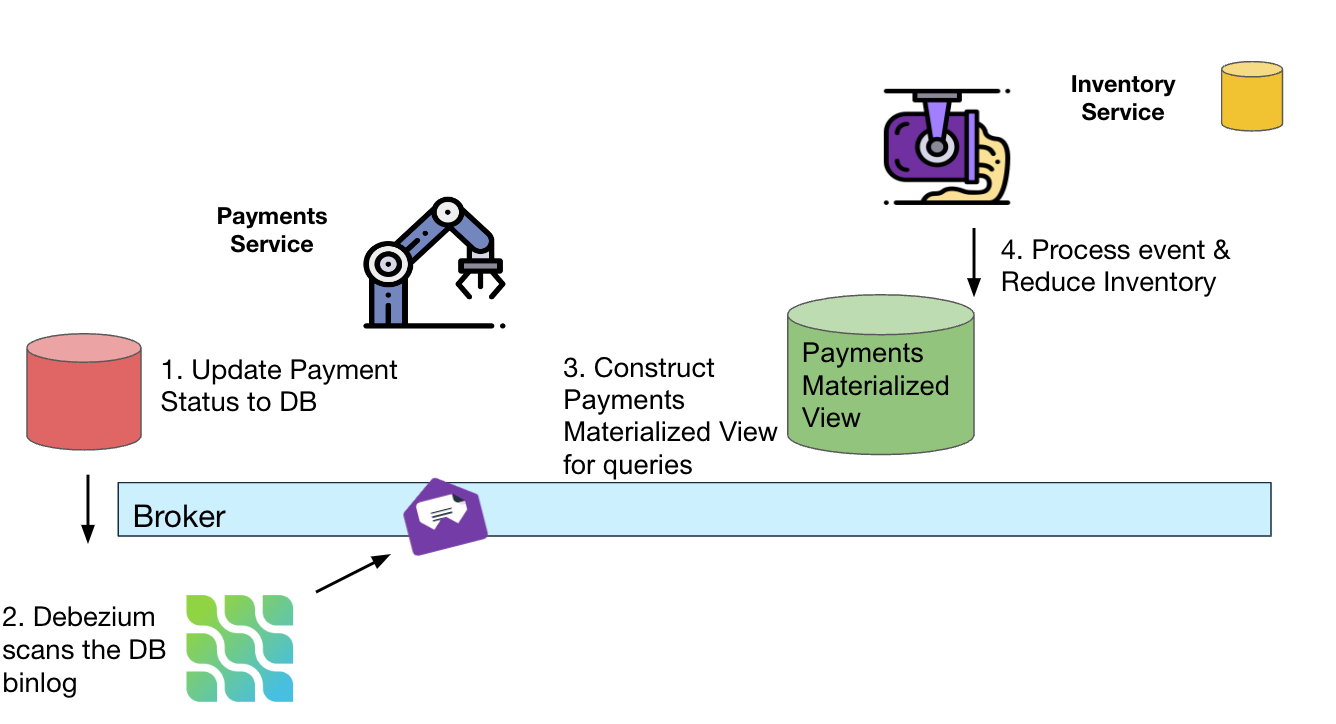 CRUD — 从 DB CDC 简单读取外部物化视图
为了避免数据库更改与其他服务之间产生的耦合,该服务可以使用 CDC 主题并生成更改事件的“官方”API,类似于在事件溯源模式中创建的事件流。
3.没有上下文传播
切换到事件驱动架构意味着开发人员、devops 和 SRE 可能更难调试生产问题并跟踪整个系统中终端用户请求的处理。
与请求-应答模型不同,没有显式的 HTTP/RPC 请求链去追踪。 调试代码更加困难,因为事件处理代码分布在服务代码中,而不是通过单击通常在同一对象/模块中找到的函数定义来顺序跟踪。
例如,考虑我在整篇文章中使用的电子商务流程。 Orders 服务必须使用来自 3 个不同主题的多个事件,所有这些事件都与同一用户操作(在网上商店购买商品)相关。
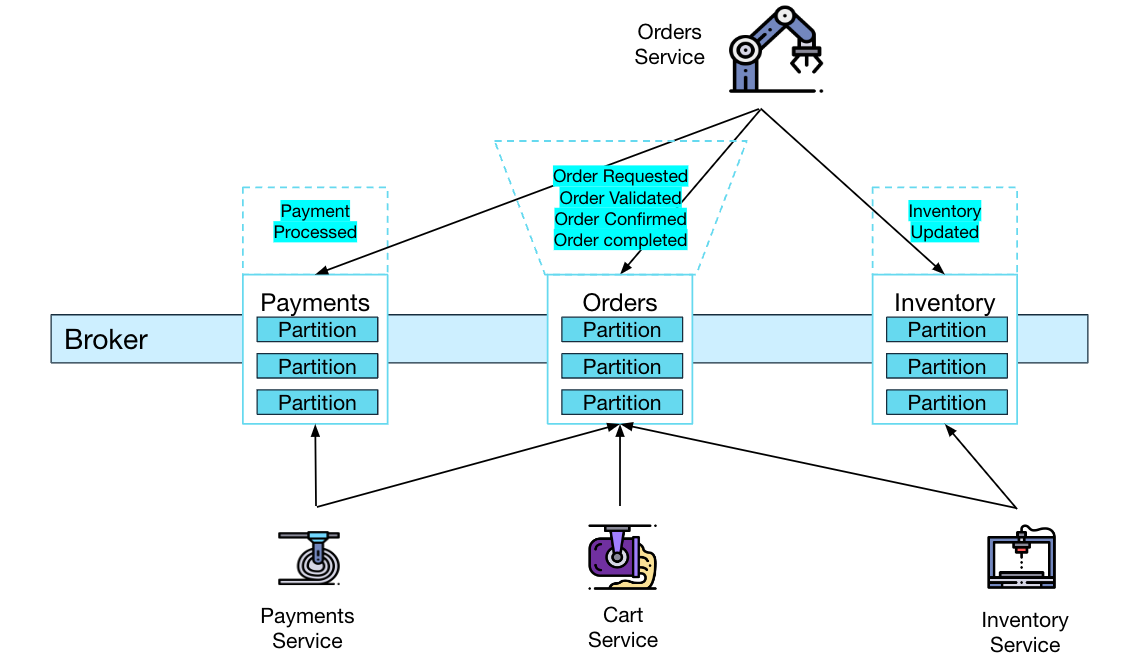 完全事件驱动的微服务,难以追踪请求流
其他服务也会从一个或多个主题中消费多个事件。 假设发现某些库存水平不正确。 能够调查所有相关的订单处理事件至关重要。 否则,将花费很长时间去查看各个服务日志并尝试手动将不同的证据连接成一个连贯的叙述。
自动上下文传播
为所有事件自动添加更广泛的请求上下文的标识,使得筛选与终端用户请求相关的所有事件变得非常简单。 在我们的电子商务示例中,添加了 2 个事件标头 — requestId 和 userId。 这两个 ID 极大地帮助我们排查问题。
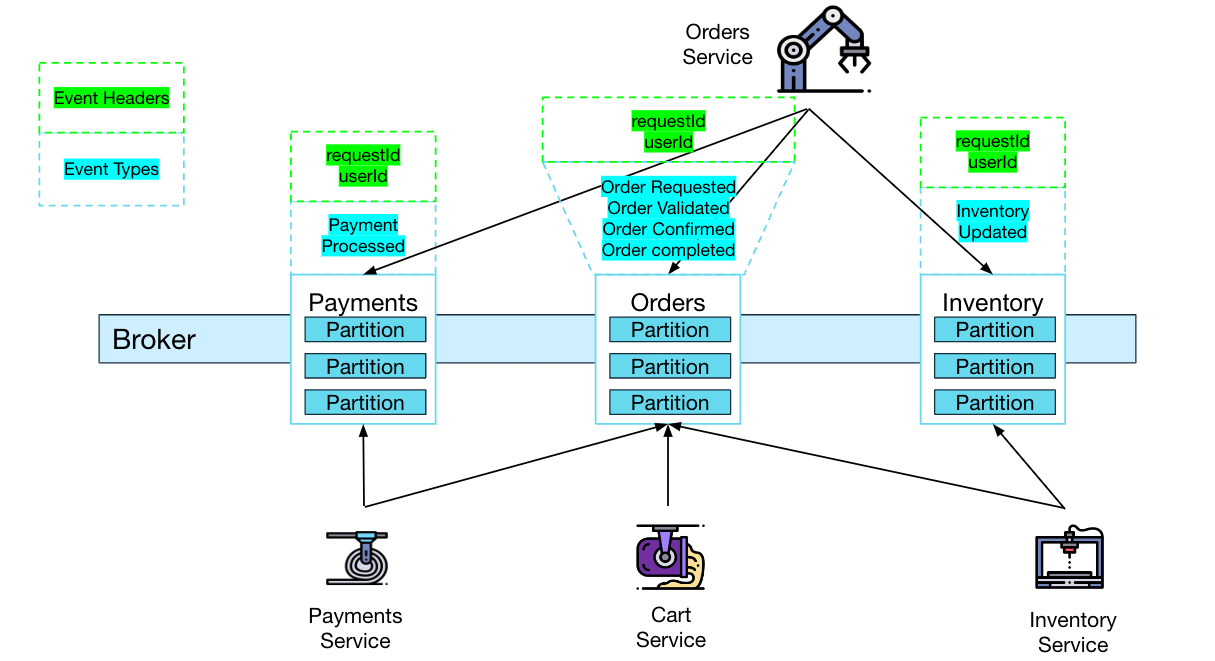 为每个事件自动附加用户请求上下文,以便于跟踪和调试
在 Wix,
Greyhound 在生成和使用事件时自动传播终端用户请求上下文。 此外,请求上下文也可以在日志基础结构中找到,这样就可以针对特定用户请求过滤日志。
4. 发布高负载事件
在处理大的事件负载(负载大于 5MB,例如图像识别、视频分析等)时,我们可能会将它们发布到 Kafka(或 Pulsar),但是这会存在延迟大大增加、吞吐量降低和内存压力增加的风险 (特别是在不使用[分层存储](
https://cwiki.apache.org/confl ... -405: Kafka Tiered Storage)时)
幸运的是,有几种方法可以解决这个问题。 包括引入压缩、将负债拆分为块、将负载放入对象存储中并在流媒体平台中传递一个引用。
高负载处理措施 I——压缩
Kafka 和
Pulsar 都允许压缩负载。 你可以尝试多种压缩类型(lz4、snappy 等)来找到最适合自己负载的类型。 如果你的负载有点大(高达 5MB),则压缩 50% 可以有效帮助你保持消息代理(Message broker)集群的良好性能。
Kafka 级别的压缩通常优于应用程序级别,因为可以批量压缩负债,从而提高压缩率。
高负载处理措施 II——分块
另一种减轻代理压力并覆盖消息大小限制的方法是将消息拆分为块。
虽然分块已经是 Pulsar 的内置
功能(有一些限制),但对于 Kafka 分块必须发生在应用程序级别。
可以在
此处和
此处找到有关如何在应用程序级别实现分块的示例。 基本前提是生产者发送带有额外元数据的块,以帮助消费者重新组装它们。
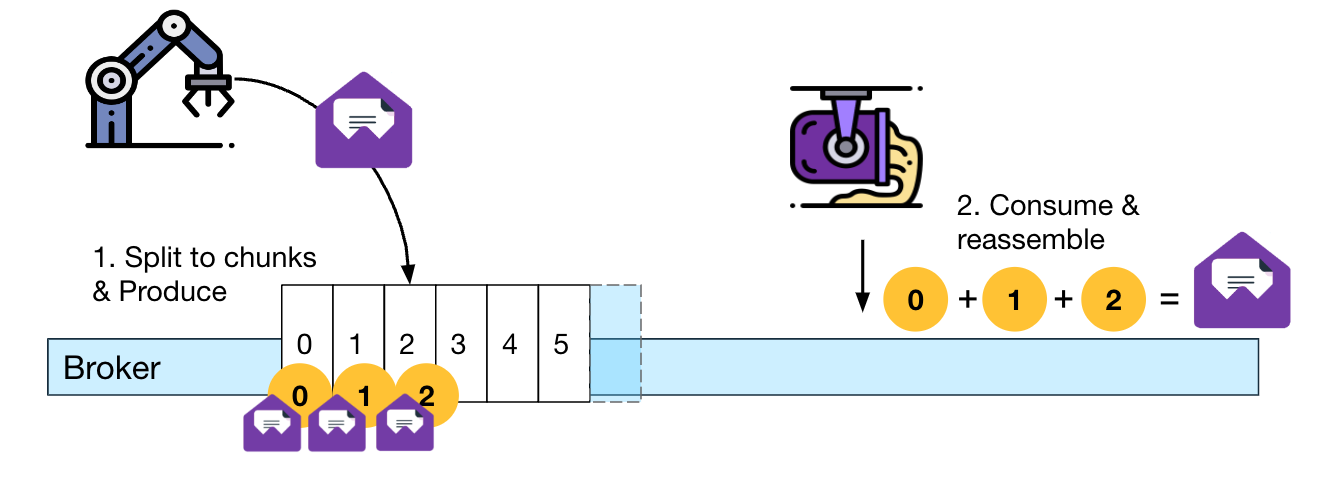 生产者分块,消费者组装
这两个示例方法的不同之处在于它们将块组装回原始负载的方式。
第一个示例将块保存在某个持久存储中,并且消费者在所有块生成后获取它们。
第二个示例是所有块都到达后,让消费者在主题分区中向后搜索到第一个块为止。
高负载处理措施 III——引用对象存储
最后一种方法是简单地将负载存储在对象存储(例如
S3)中,并将引用(通常是 URL)传递给事件负载中的对象。 这些对象存储可以在不影响延迟的情况下,保留任何所需的负载大小。
重要的是要确保在生成链接之前负载已完全上传到对象存储,否则消费者将需要不断重试,直到可以开始下载为止。
5.没有处理重复事件
大多数消息代理和事件流平台默认
至少保证一次传递。 这意味着某些事件在流中重复或可能被处理两次(或更多次)。
确保重复事件的副作用只发生一次的术语是
幂等性。
考虑一下我在整篇文章中使用的简单电子商务流程。 如果由于某些处理错误而导致重复处理,则记录在库存数据库中的采购商品的库存水平可能会比实际下降的多。
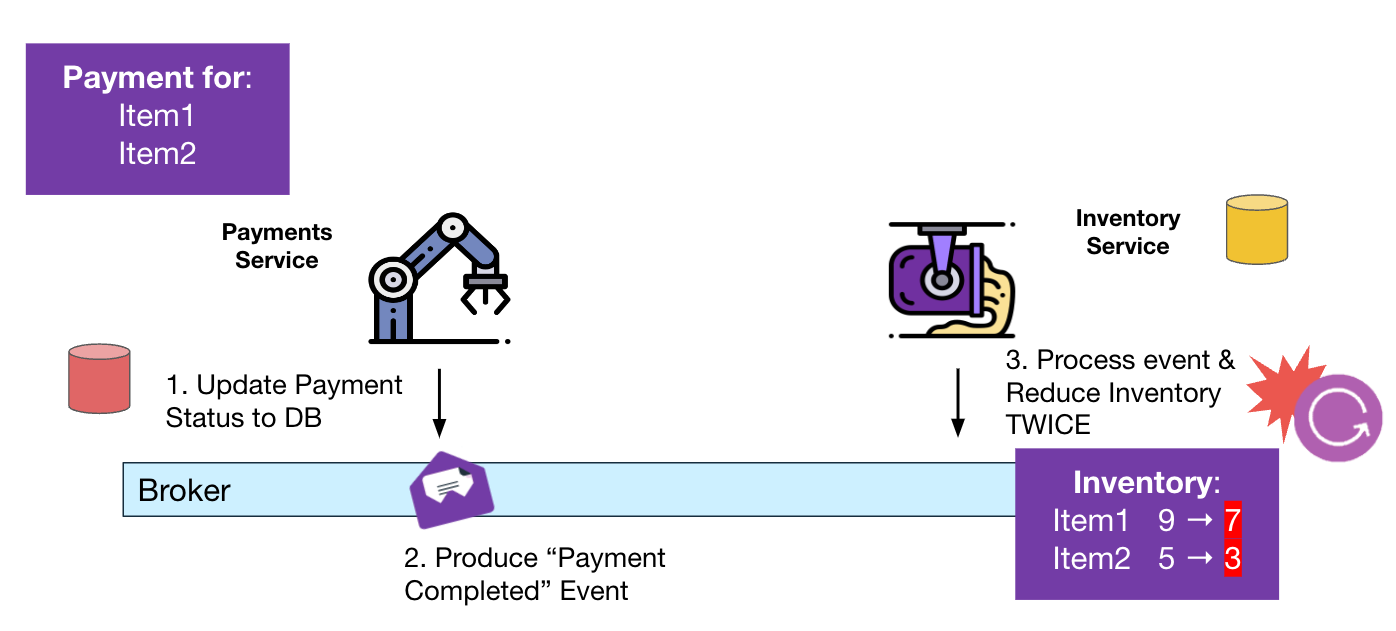 双重消费导致库存水平变得不正确
幂等处理措施——revisionId(版本控制)
在需要事件处理的幂等性的情况下,
乐观锁技术可以作为一种方法。 使用这种技术,在任何更新发生之前首先读取存储实体的当前 revisionId(或版本)。 如果不止一方尝试同时(并发)更新实体(同时增加版本),则第二次尝试将失败,因为版本将不再与之前读取的内容匹配。
在幂等处理重复事件的情况下,revisionId 必须是唯一的并且是事件本身的一部分,以确保两个事件不共享相同的 id 并且同一 revisionId 的第二次更新将(静默)失败 即使不是同时发生。
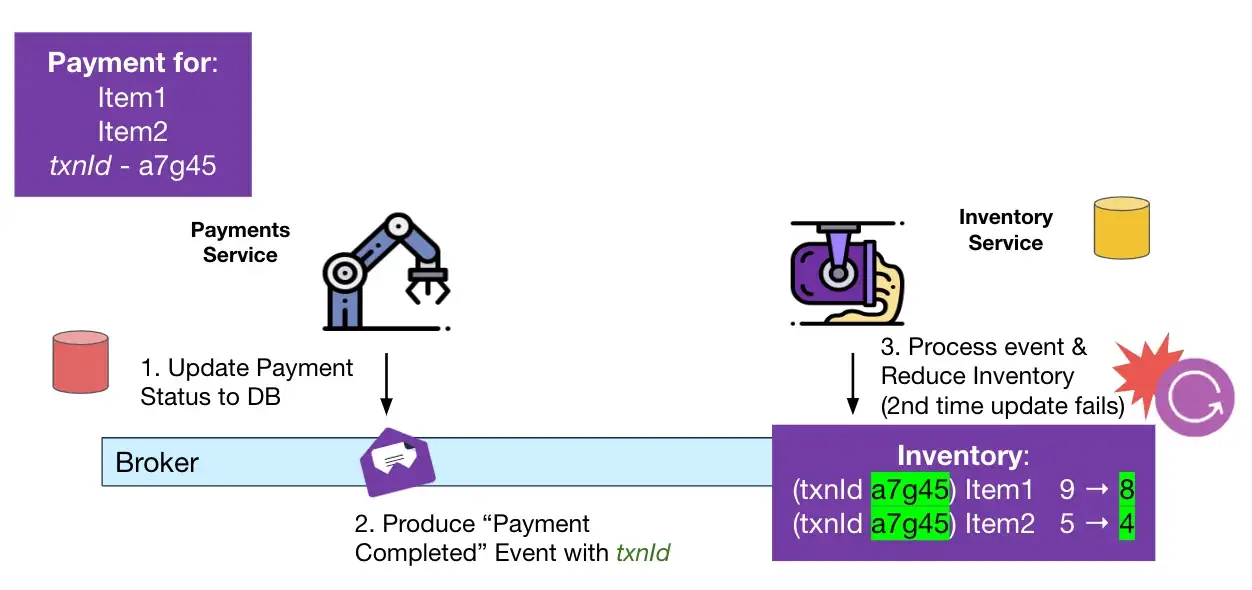 为每个事件附加 transactionId 以避免重复处理
特别是对于 Kafka,有可能配置了
精确的一次语义,但由于某些故障仍然可能发生数据库重复更新。 幸运的是,这种情况下txnId可以作为主题分区的偏移量,从而保证事件的唯一性。
* 有关 Kafka 中的 Exactly once delivery 的更多信息,可以观看我在 DevOpsDays Tel Aviv 大会上的[演讲](
https://www.youtube.com/watch?v=7O_UC_i1XY0